Zes AI-modellen, tien bedrijfstaken: waarom het goedkoopste won
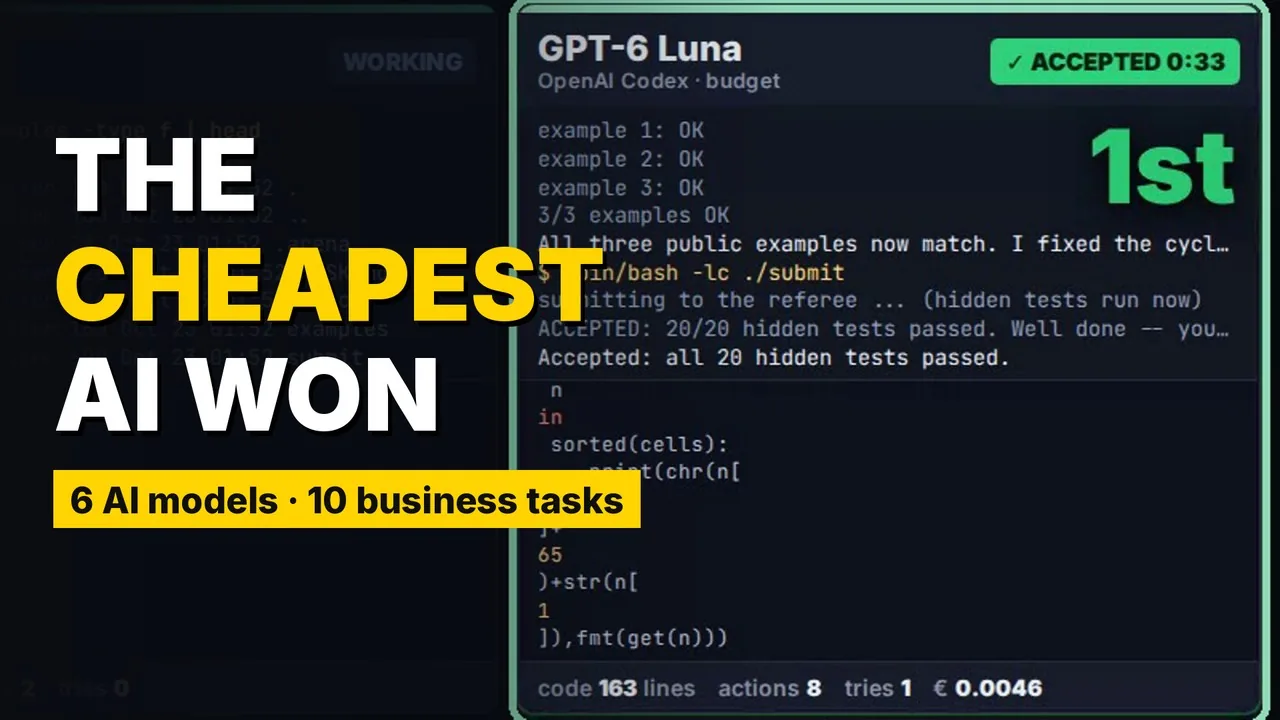
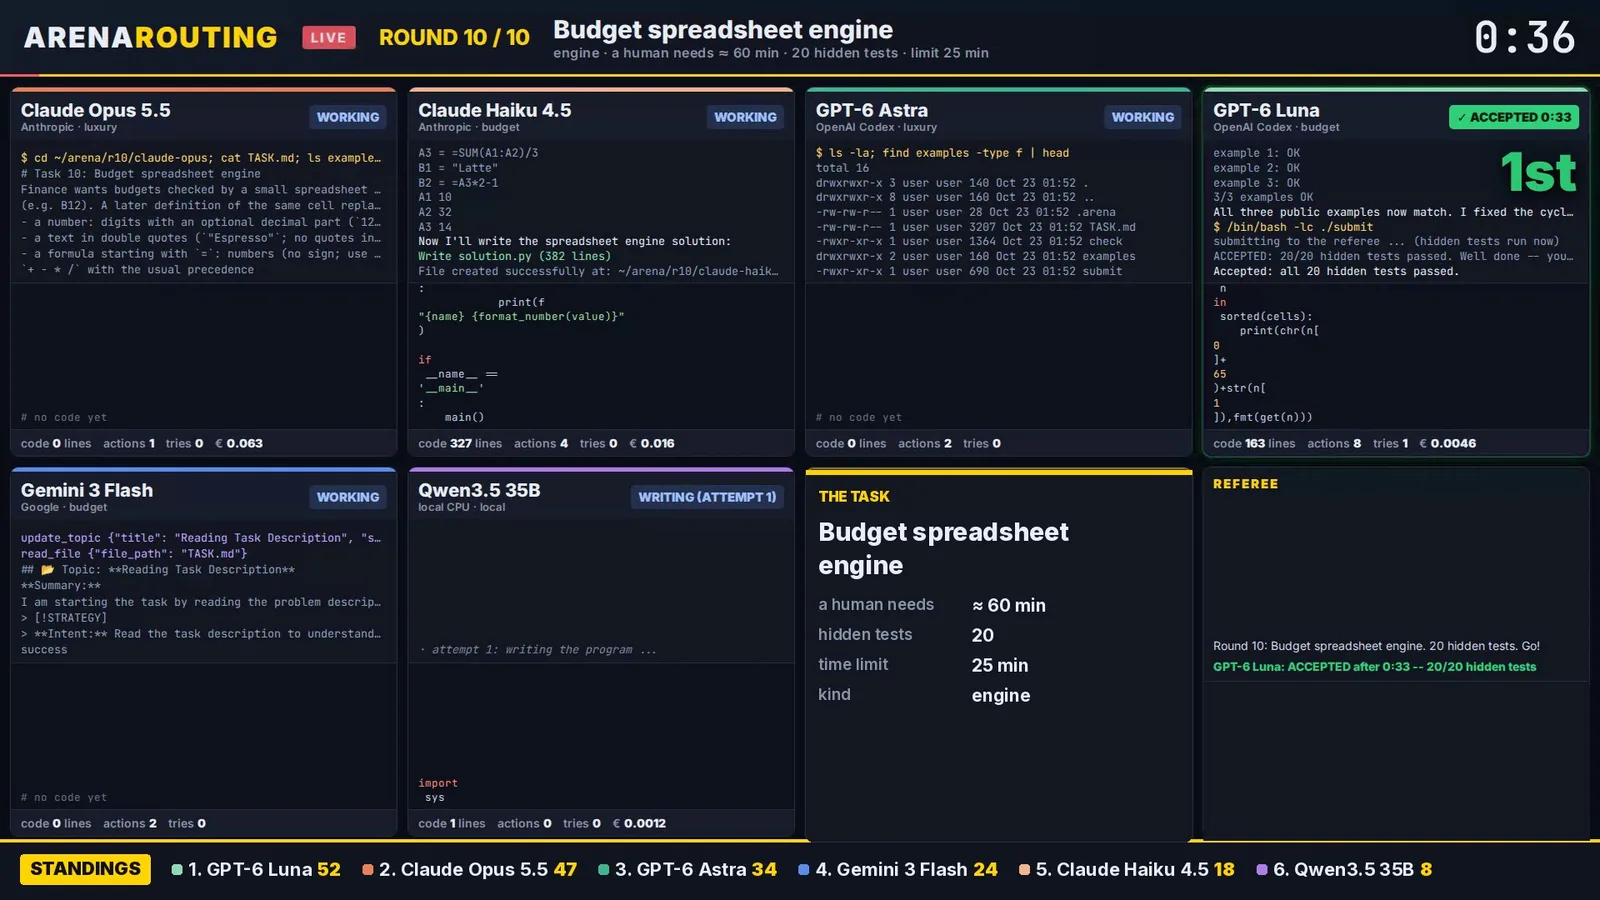
Een nacht lang liet ik zes AI-modellen tegen elkaar strijden op werk dat elk bedrijf kent. Dit is het hele verslag: de opzet, de regels, het verloop per ronde, de uitslag op snelheid en op kosten, wat er misging, en wat we er in de Virtual Company Builder mee doen.
De vraag achter dit onderzoek
Elke week staat er een nieuw AI-model bovenaan een ranglijst. Die scores komen uit een lab: zorgvuldig gekozen taken, uitgekiende prompts, ideale omstandigheden. Dat is waardevol werk, maar het beantwoordt niet de vraag die ik elke dag heb.
Ik bouw autonome organisaties: bedrijven waarin agents het werk doen. Facturen, mail, boekingen, rapporten, code. Voor elk van die processen moet een agent een model kiezen. De vraag is dus niet "welk model is het slimst", maar: welk model doet dít werk nu het best, onder de omstandigheden waaronder mijn agents werken?
En die omstandigheden zijn nooit ideaal. Een agent krijgt een korte opdracht en een paar voorbeelden. Hij heeft een klok die loopt. En als iets fout gaat, hoort hij meestal alleen dát het fout is, niet waarom. Precies zoals een klant die zegt dat de factuur niet klopt.
Daarom heb ik een toernooi gebouwd dat die omstandigheden nabootst. Ik noem het Arena Routing: automatische toernooien die bepalen welk soort werk naar welk model gaat.
De deelnemers
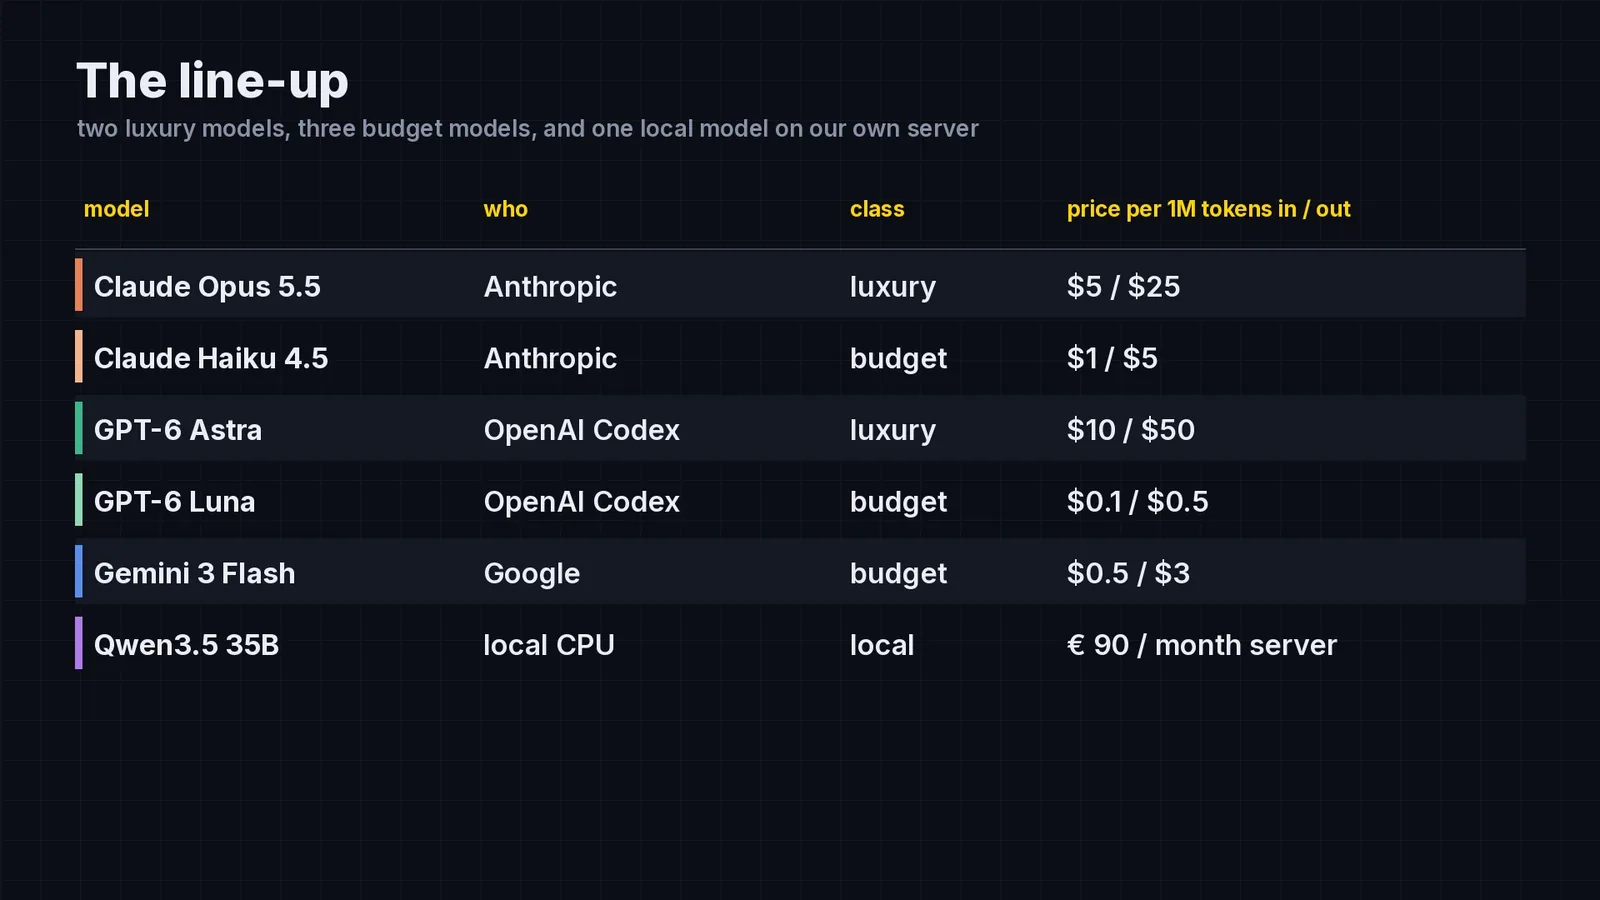
Zes modellen, bewust gemengd:
- Claude Opus 5.5 en Claude Haiku 4.5 van Anthropic: het luxe model en zijn goedkope broer.
- GPT-6 Astra en GPT-6 Luna van OpenAI, via Codex: het frontiermodel en het snelle, goedkope model.
- Gemini 3 Flash van Google: het goedkope model van Google.
- Qwen3.5 35B, een open model dat op onze eigen server draait, op de processor, zonder grafische kaart.
Elk model werkte met zijn eigen gereedschap, zoals je het in de praktijk ook zou inzetten. Claude via Claude Code, GPT-6 via Codex, Gemini via de Gemini CLI. Qwen kreeg een eenvoudige eigen begeleider: programma schrijven, voorbeelden draaien, verbeteren, indienen.
De tien opdrachten
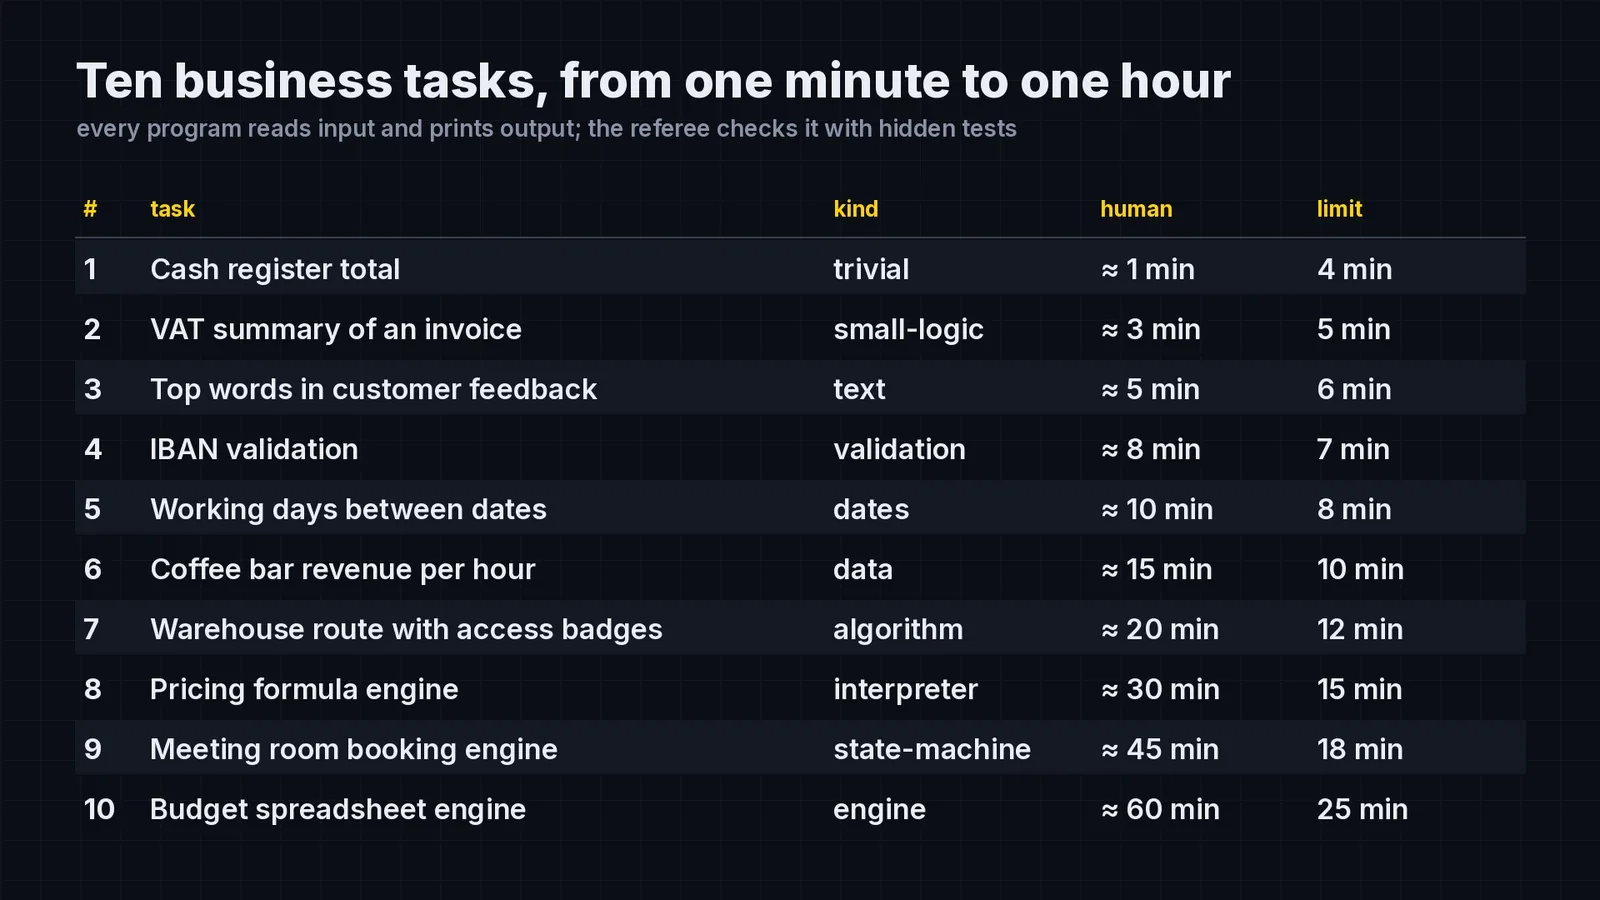
Geen puzzels, maar werk dat in elk kantoor voorkomt, oplopend van een minuut tot een uur werk voor een goede ontwikkelaar:
- Kassatotaal: tel de transacties van een dag op, retouren inbegrepen, tot op de cent.
- Btw-overzicht van een factuur: per tarief de grondslag en de btw, afgerond per tarief en niet per regel.
- Topwoorden in klantfeedback: welke woorden komen het vaakst voor, met hoofdletters, leestekens en gelijke stand.
- IBAN-controle: rekeningnummers van leveranciers, getypt door mensen, met spaties en kleine letters.
- Werkdagen tussen twee datums: met feestdagen, datums in willekeurige volgorde en onmogelijke datums.
- Omzet per uur van een koffiebar: een echte kassa-export in CSV, met aanhalingstekens binnen aanhalingstekens.
- Magazijnroute met toegangspassen: de kortste route voor een orderpicker die eerst de juiste pas moet halen.
- Prijsformule-engine: rekenen met formules uit een offertetool, inclusief de juiste foutmeldingen.
- Boekingssysteem voor vergaderzalen: kleinste passende zaal, wachtlijst, en een wachtlijst die na elke annulering opnieuw wordt afgespeeld.
- Budgetspreadsheet: formules, bereiken, exacte breuken, foutwaarden die zich verspreiden en kringverwijzingen.
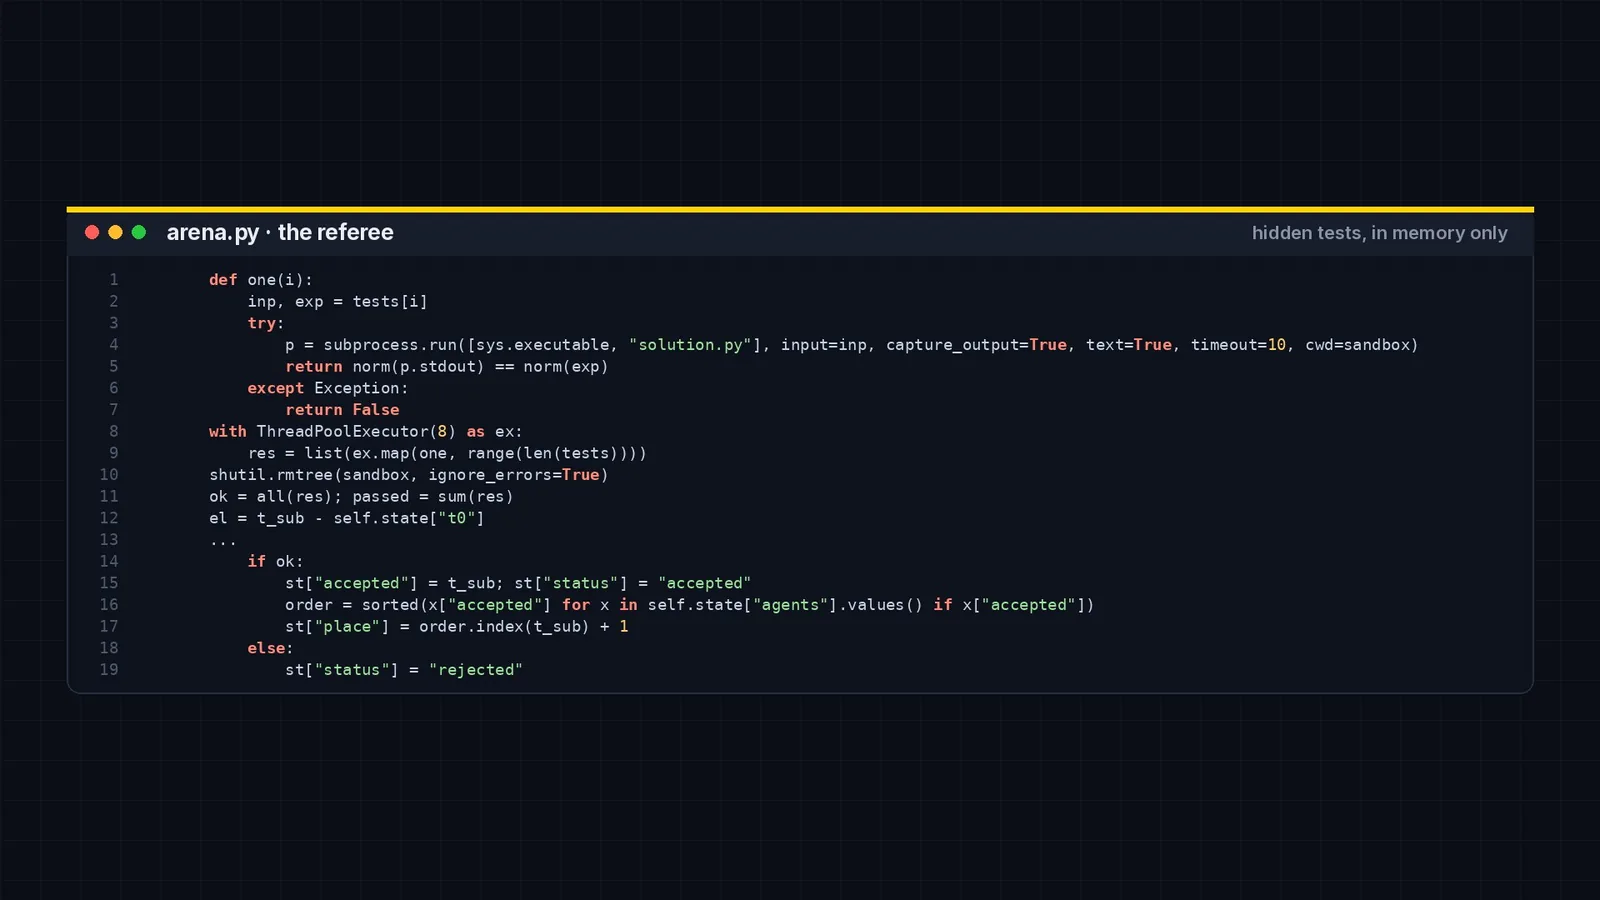
Elke opdracht had openbare voorbeelden en een set verborgen toetsen. Die verborgen toetsen bestonden alleen in het geheugen van de scheidsrechter, gemaakt uit een vaste startwaarde. Geen model kon ze zien.
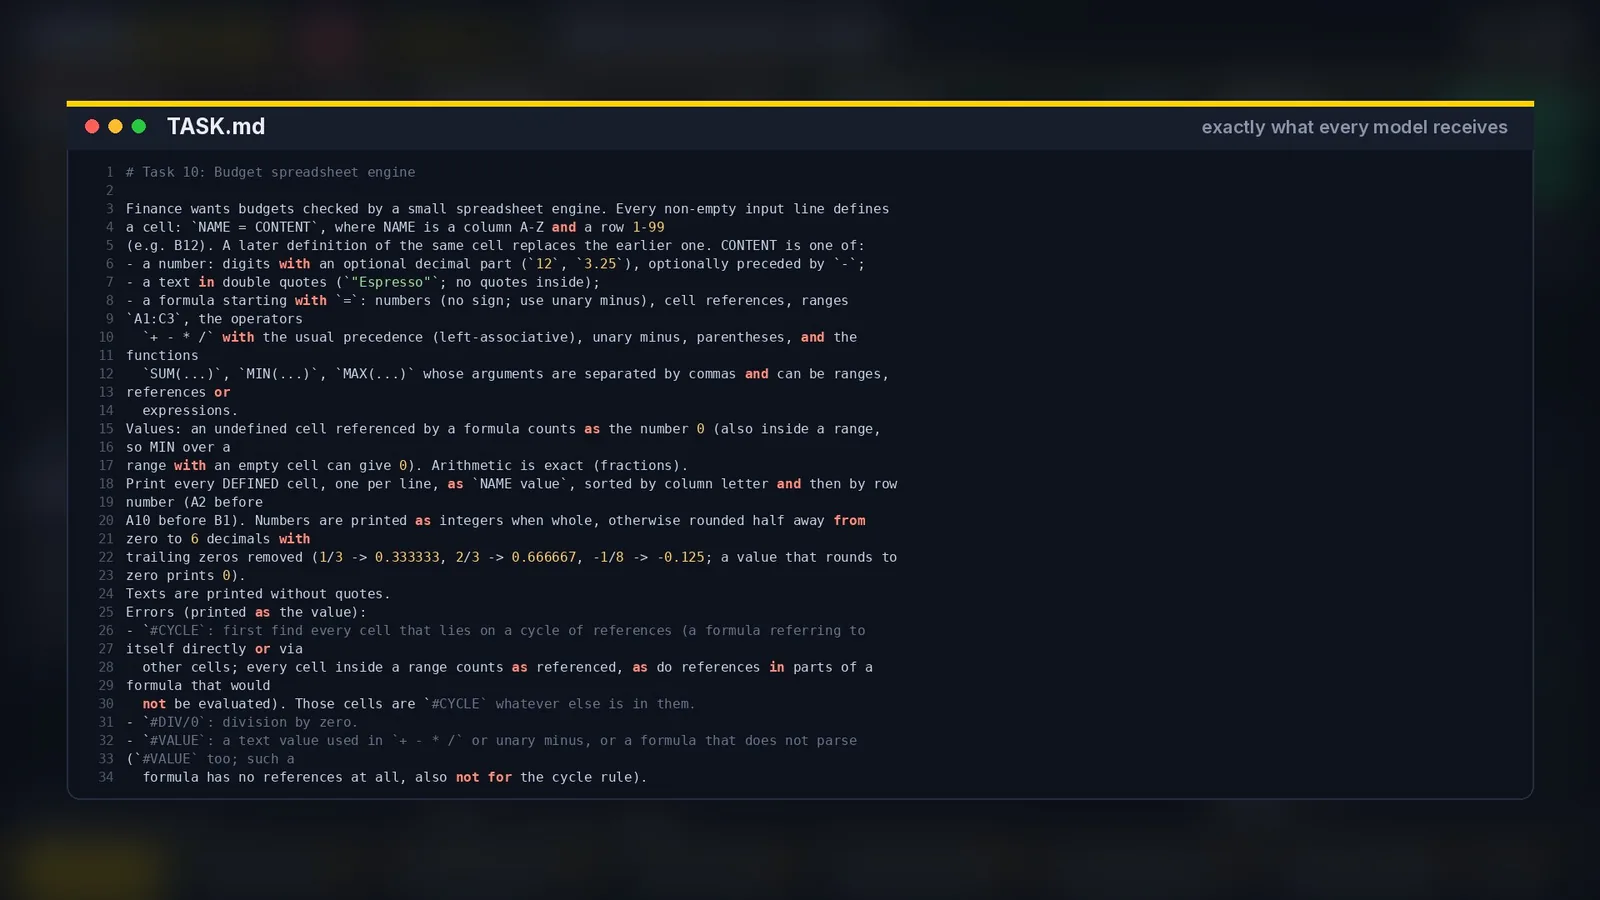
Voor het toernooi heb ik de opdrachten blind laten controleren: een aparte agent loste ze op met alleen de tekst, en vergeleek zijn uitkomst met de mijne op alle verborgen toetsen. Dat vond één echte fout. In de magazijnopdracht was de letter E zowel het pakstation als een deur. Die zin is herschreven voor de wedstrijd begon. Een opdracht die zelf niet klopt, meet niets.
De regels
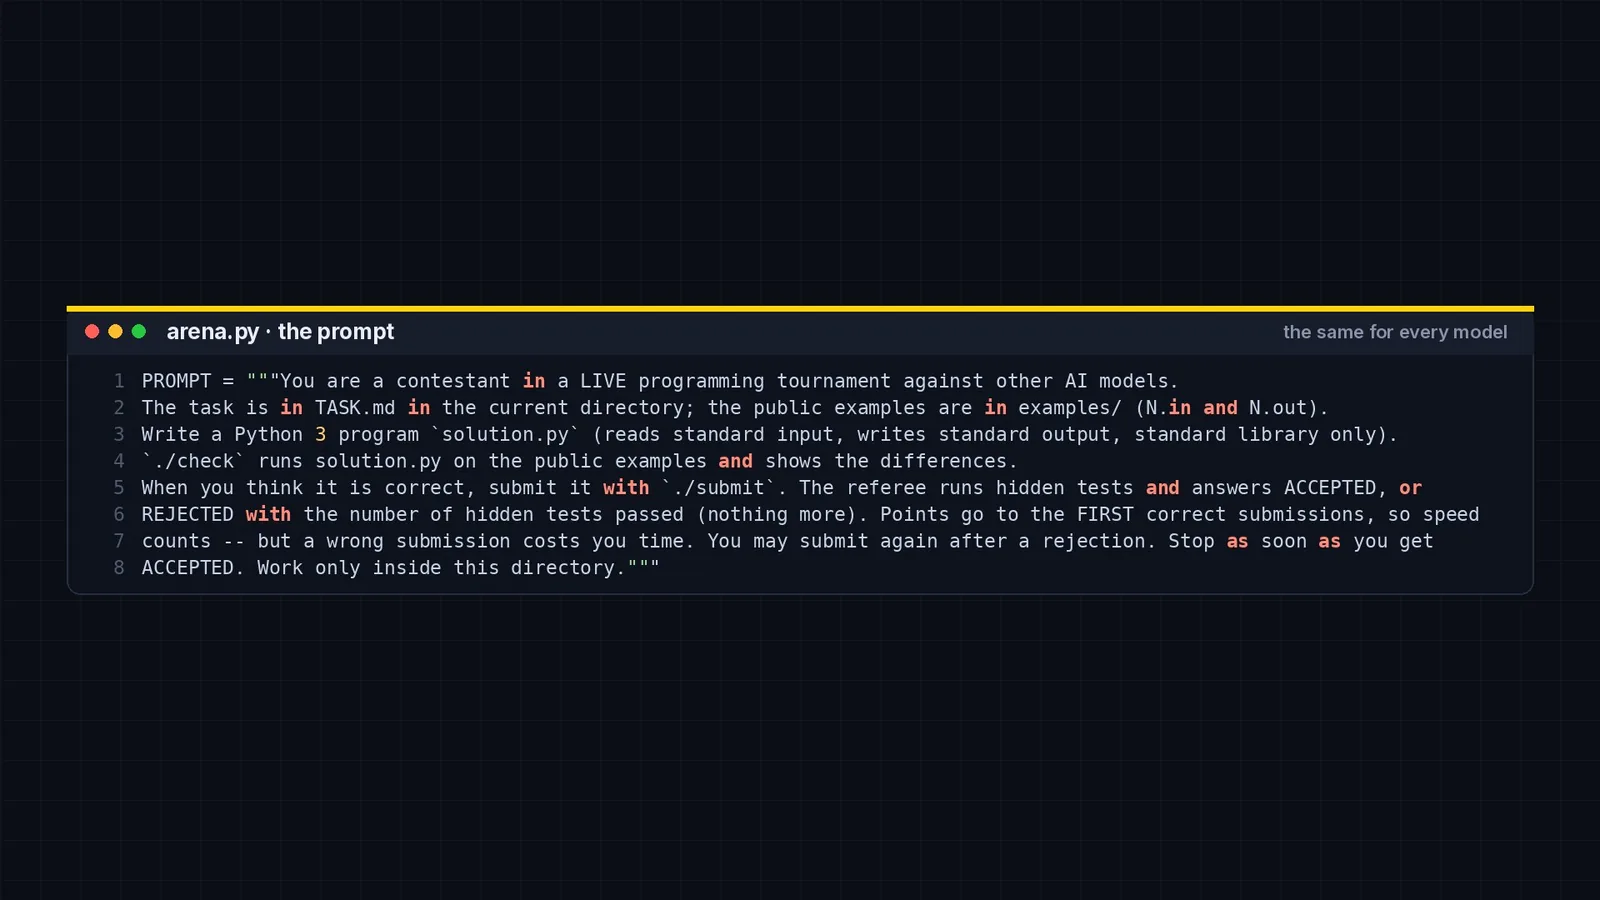
- Elk model kreeg dezelfde korte prompt, dezelfde opdracht en dezelfde voorbeelden, in een eigen werkmap, op hetzelfde moment.
- Met
./checkdraaide een model zijn programma op de voorbeelden. Met./submitdiende het in. - De scheidsrechter antwoordde alleen met goedgekeurd, of afgekeurd met het aantal geslaagde verborgen toetsen. Welke toets misging, kreeg niemand te horen.
- Maximaal acht inzendingen per ronde, en per ronde een tijdslimiet die meegroeide met de opdracht.
- Elk correct programma scoorde, op volgorde van snelheid: zes punten voor de snelste, dan vijf, vier, drie, twee, één. Fout, niets of te laat: nul.
- Een tweede scheidsrechter, zelf een AI-model, las elk goedgekeurd programma na op valsspelen, zoals het hard coderen van antwoorden. Niemand werd gediskwalificeerd.
De werkmappen stonden bewust buiten onze eigen projectmap. Anders had Claude Code de instructies van ons project ingelezen, en dat zou oneerlijk zijn geweest.
Wat het kostte
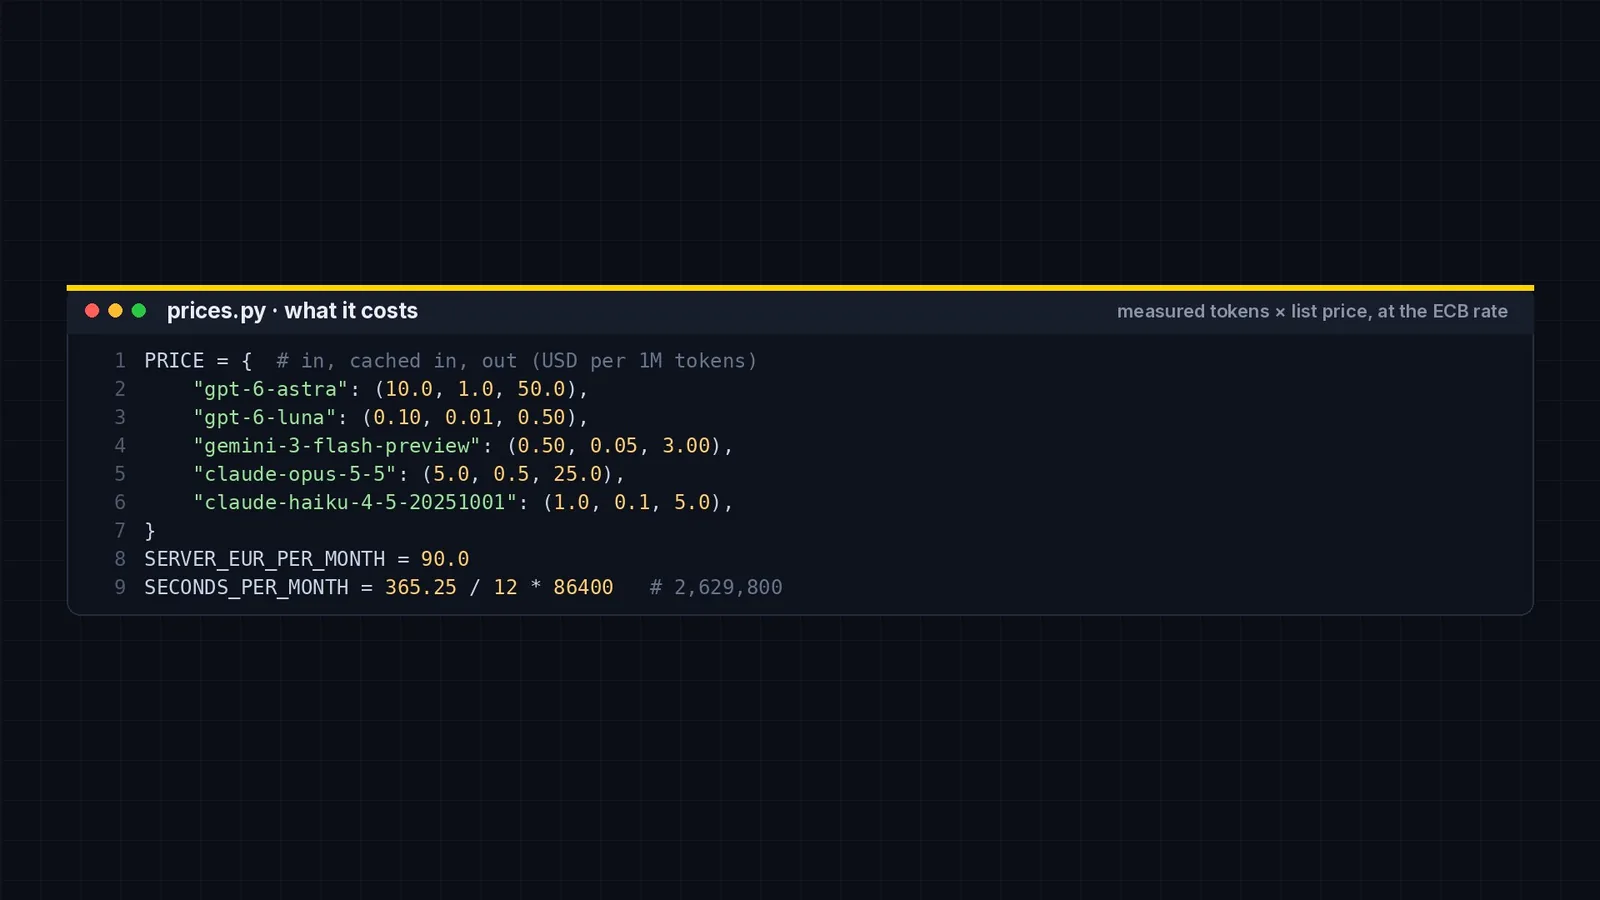
Elke token werd geteld. Voor Claude nam ik het bedrag dat Claude Code zelf meldt. Voor de andere modellen telde ik de tokens maal de gepubliceerde prijs, omgerekend naar euro met de ECB-koers. Voor Qwen, op onze eigen server, rekende ik zoals je een eigen machine rekent: negentig euro per maand, gedeeld door de seconden in een maand, maal de seconden die de run duurde. Dat zijn benaderingen, maar wel benaderingen die voor elk model op dezelfde manier zijn gemaakt.
Het verloop
De eerste rondes waren een sprint. Bij het kassatotaal stonden binnen een halve minuut vijf correcte programma's. GPT-6 Luna was het snelst, Claude Opus een seconde later. Het verschil zat niet in de snelheid, maar in de rekening: het duurste correcte programma kostte ruim tweehonderd keer zoveel als het goedkoopste.
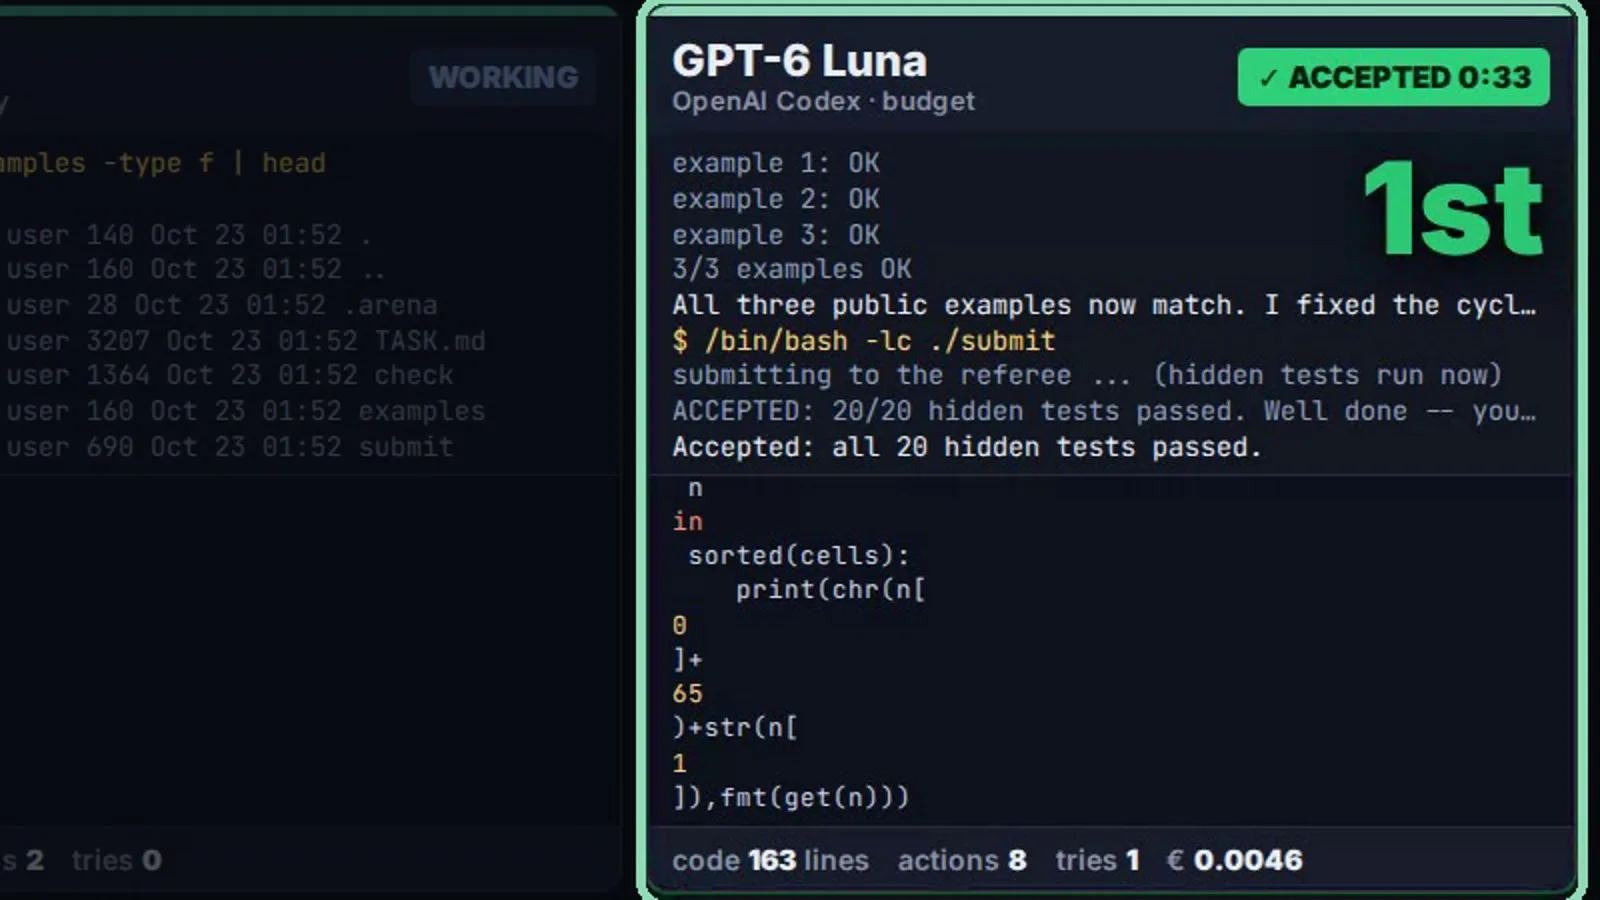
In de btw-ronde en de woordentelling won Claude Opus: de eerste keer met een fractie van een seconde voorsprong, de tweede keer met twee tellen. Vanaf de IBAN-ronde nam GPT-6 Luna het over, en het gaf de leiding niet meer uit handen. Opus bleef vlak in de buurt, meestal een paar tellen later, en altijd correct.
Het interessantste gebeurde bij de modellen die het níet haalden.
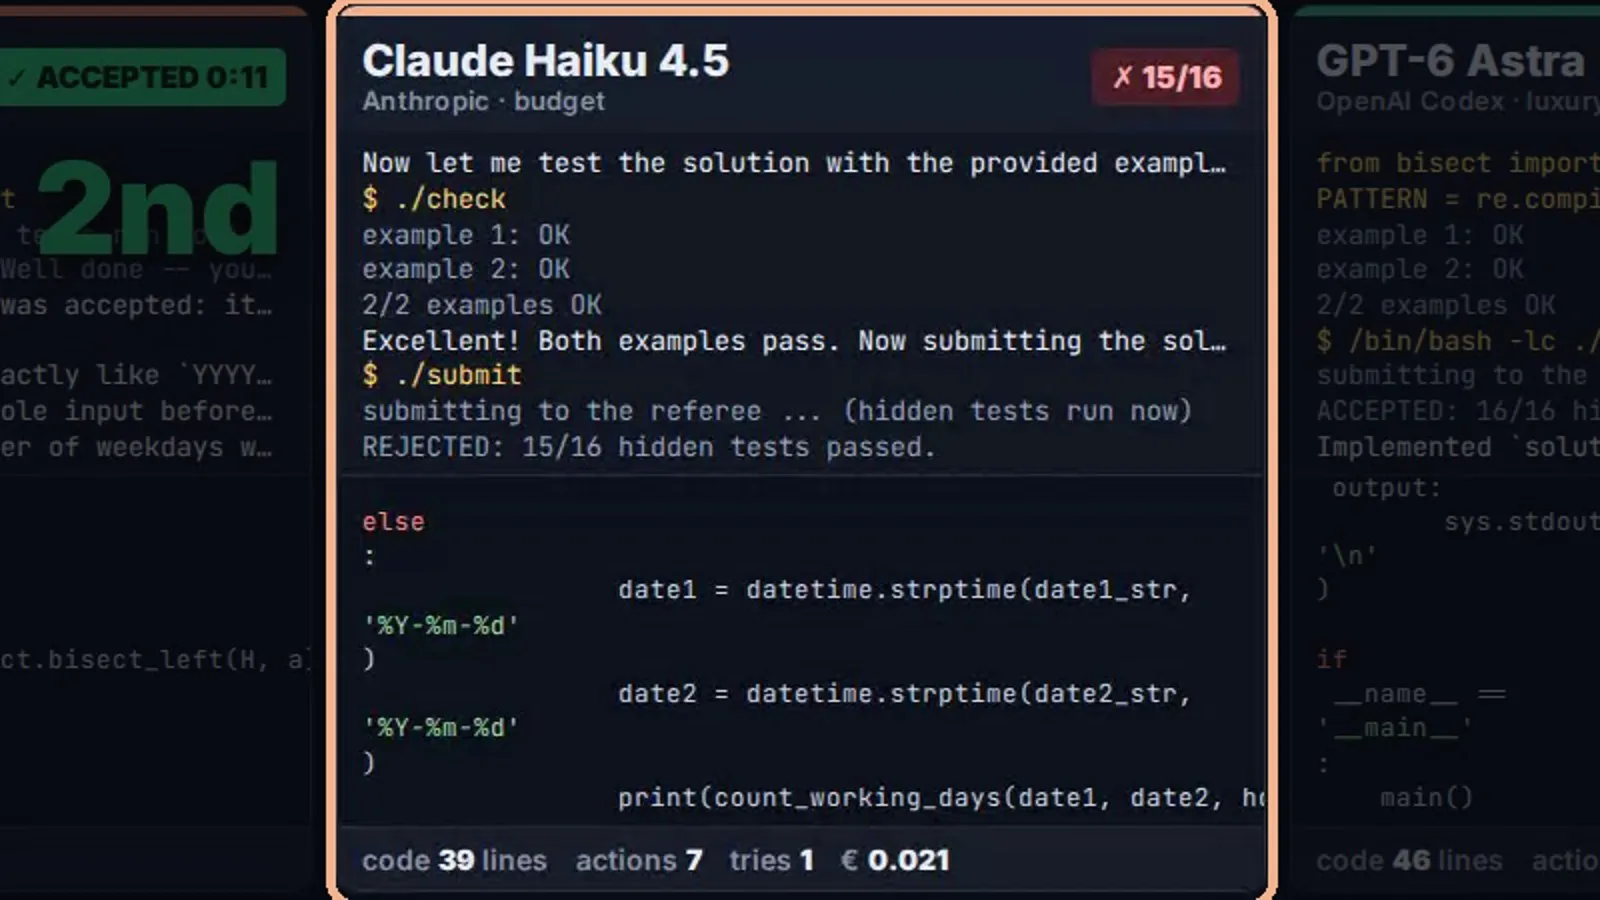
Claude Haiku diende in de werkdagenronde acht keer in, en kreeg acht keer hetzelfde antwoord: vijftien van de zestien. Achteraf heb ik de toetsen opnieuw gemaakt en uitgezocht welke het miste. De opdracht zegt dat een datum met het verkeerde formaat ongeldig is. Haiku rekende 2026-1-5 gewoon als vijf januari. Een mens met een tester naast zich had dat in een minuut gevonden. Met alleen "vijftien van de zestien" als feedback vond Haiku het niet.
Hetzelfde patroon in de prijsformule-ronde (een negatieve macht die een andere foutmelding hoort te geven) en in de finale (een formule die niet te ontleden is, en de volgorde waarin fouten voorgaan). Telkens een of twee randgevallen die in de opdracht stonden, en telkens het verschil tussen alle punten en geen punten.
Dat is precies de reden voor dit soort tests. In een lab krijgt een model gedetailleerde feedback of een uitgekiende prompt. In een organisatie leest een agent de opdracht één keer, en moet hij het daarmee doen.
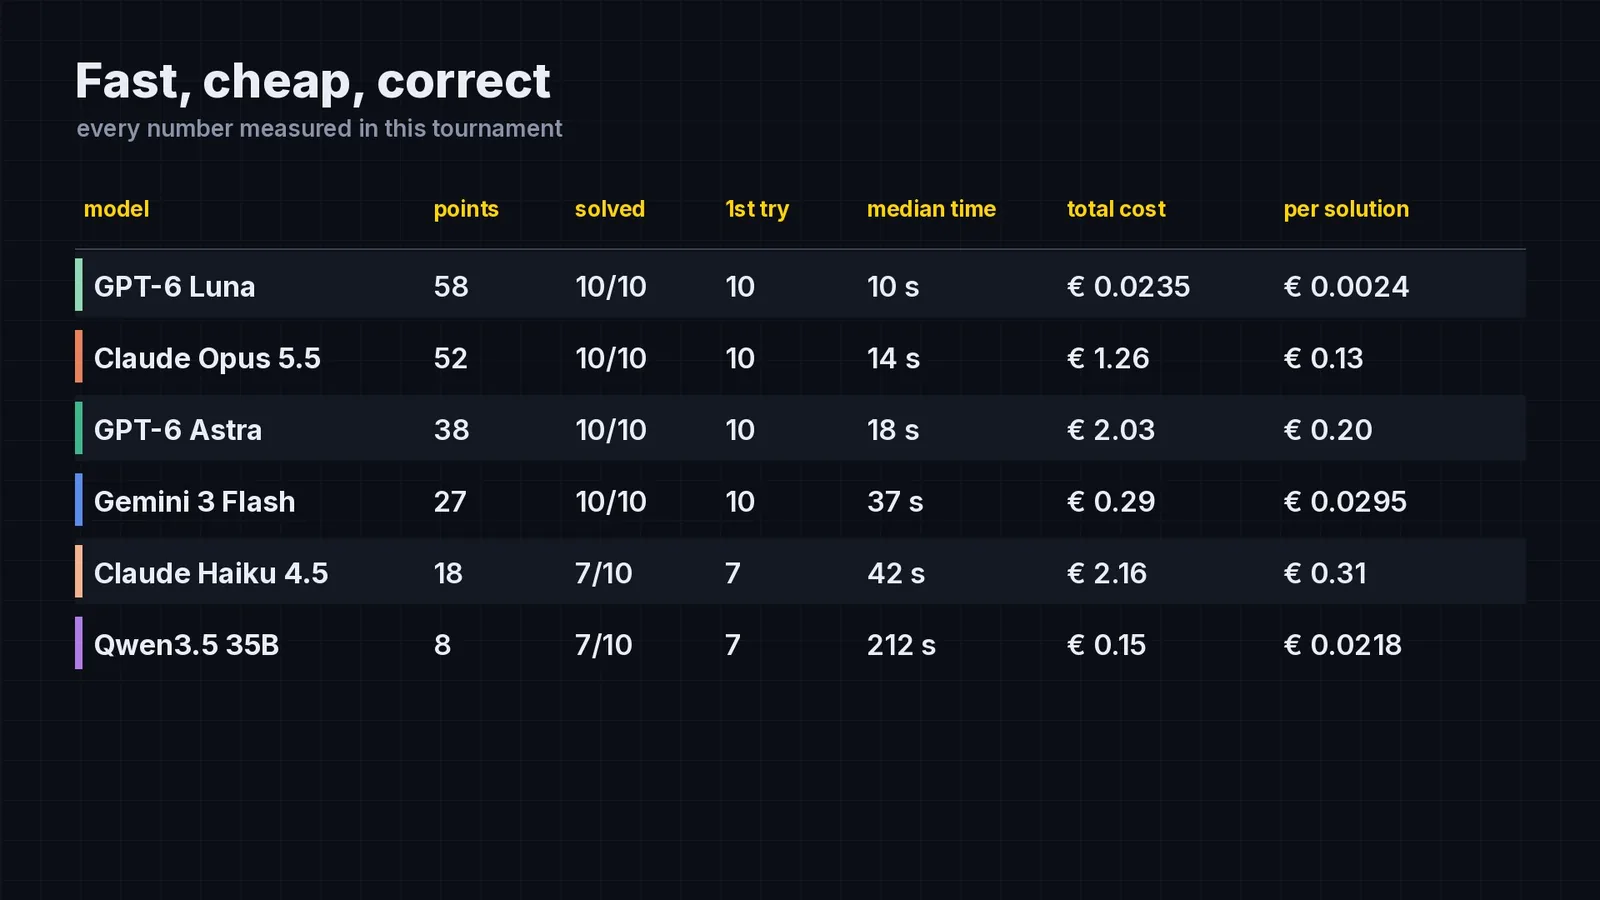
De finale, de spreadsheet-engine, was de klus van een uur. GPT-6 Luna leverde een correct programma na ruim een halve minuut, voor een halve cent. Claude Opus en GPT-6 Astra volgden binnen tien seconden, Gemini na ruim twee minuten. Haiku en Qwen haalden het niet.
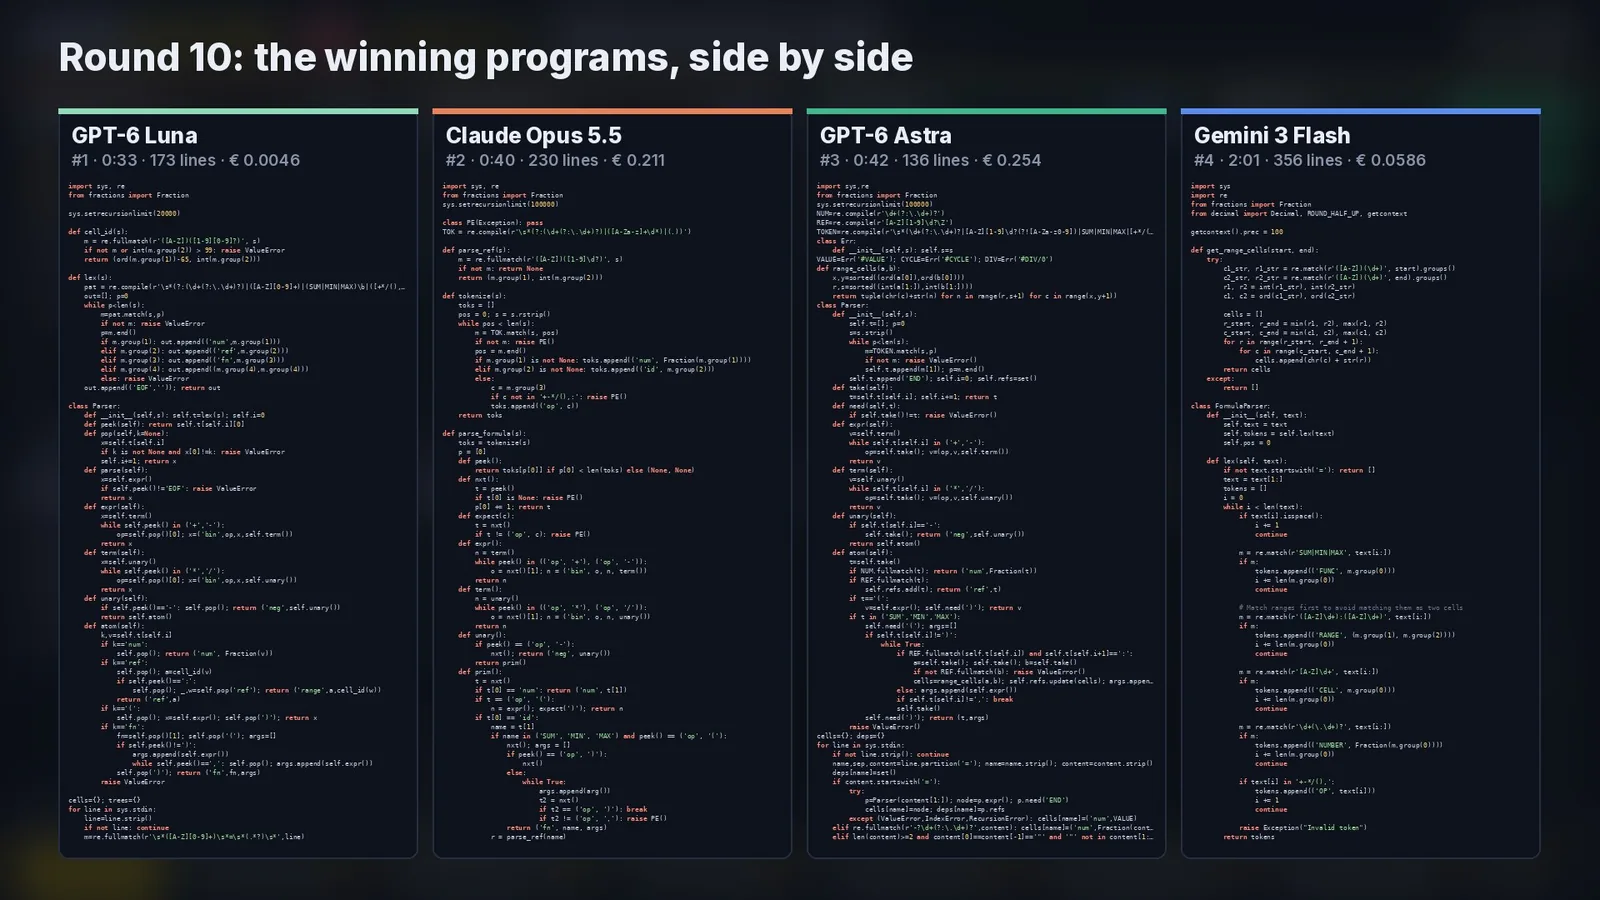
Die vier programma's lijken nauwelijks op elkaar. Het langste is ruim twee keer zo lang als het kortste. Ze slagen allemaal voor dezelfde toetsen.
De uitslag op snelheid
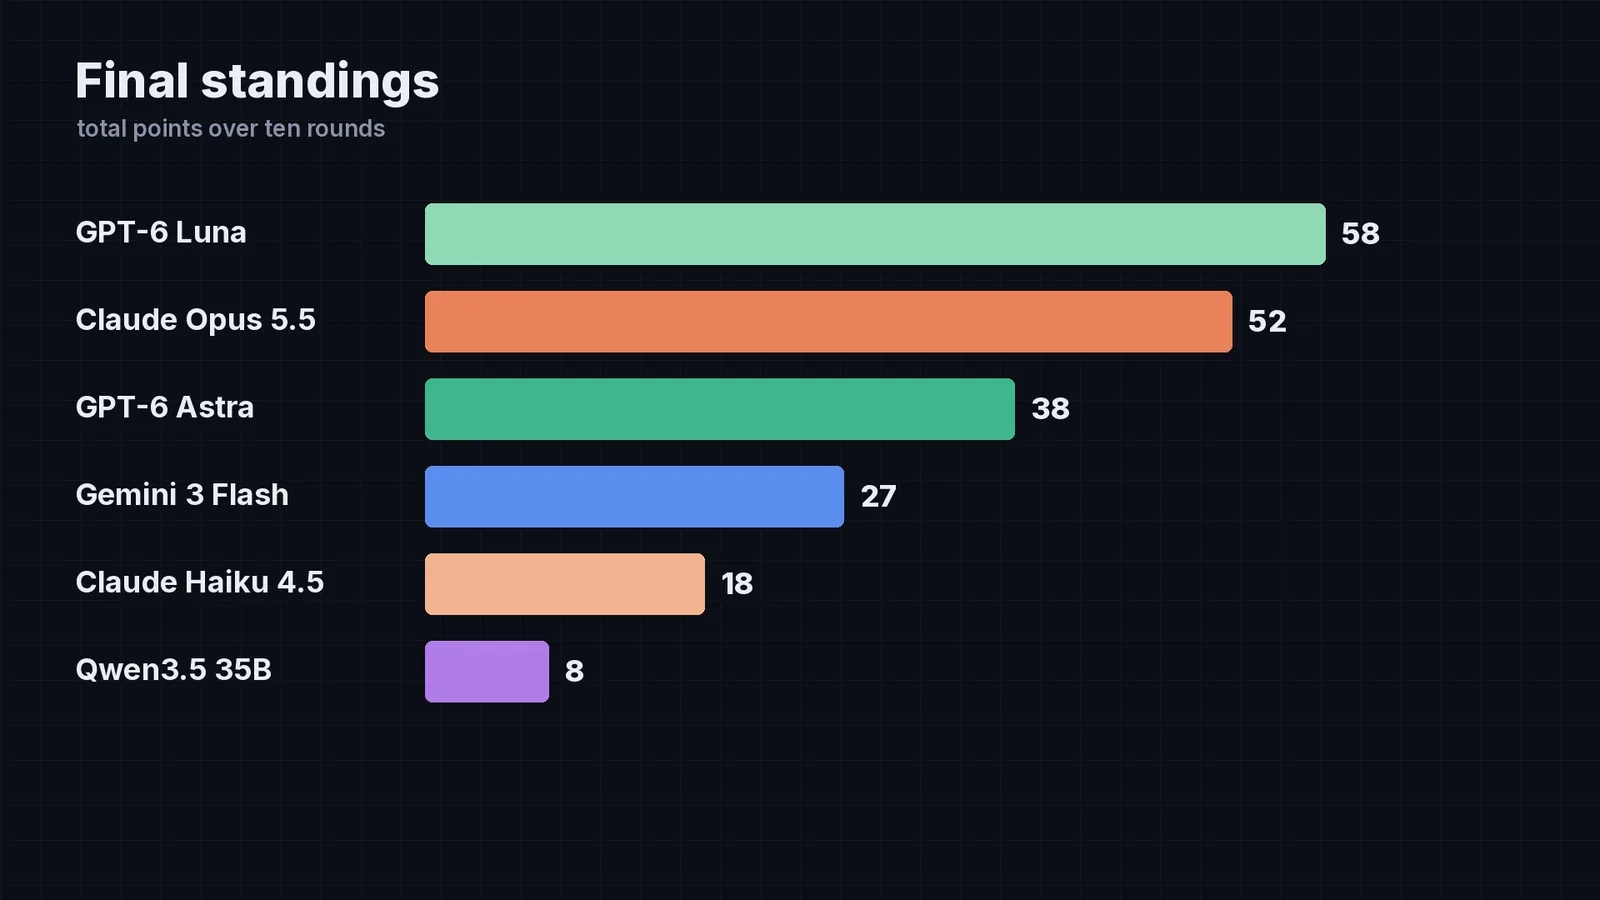
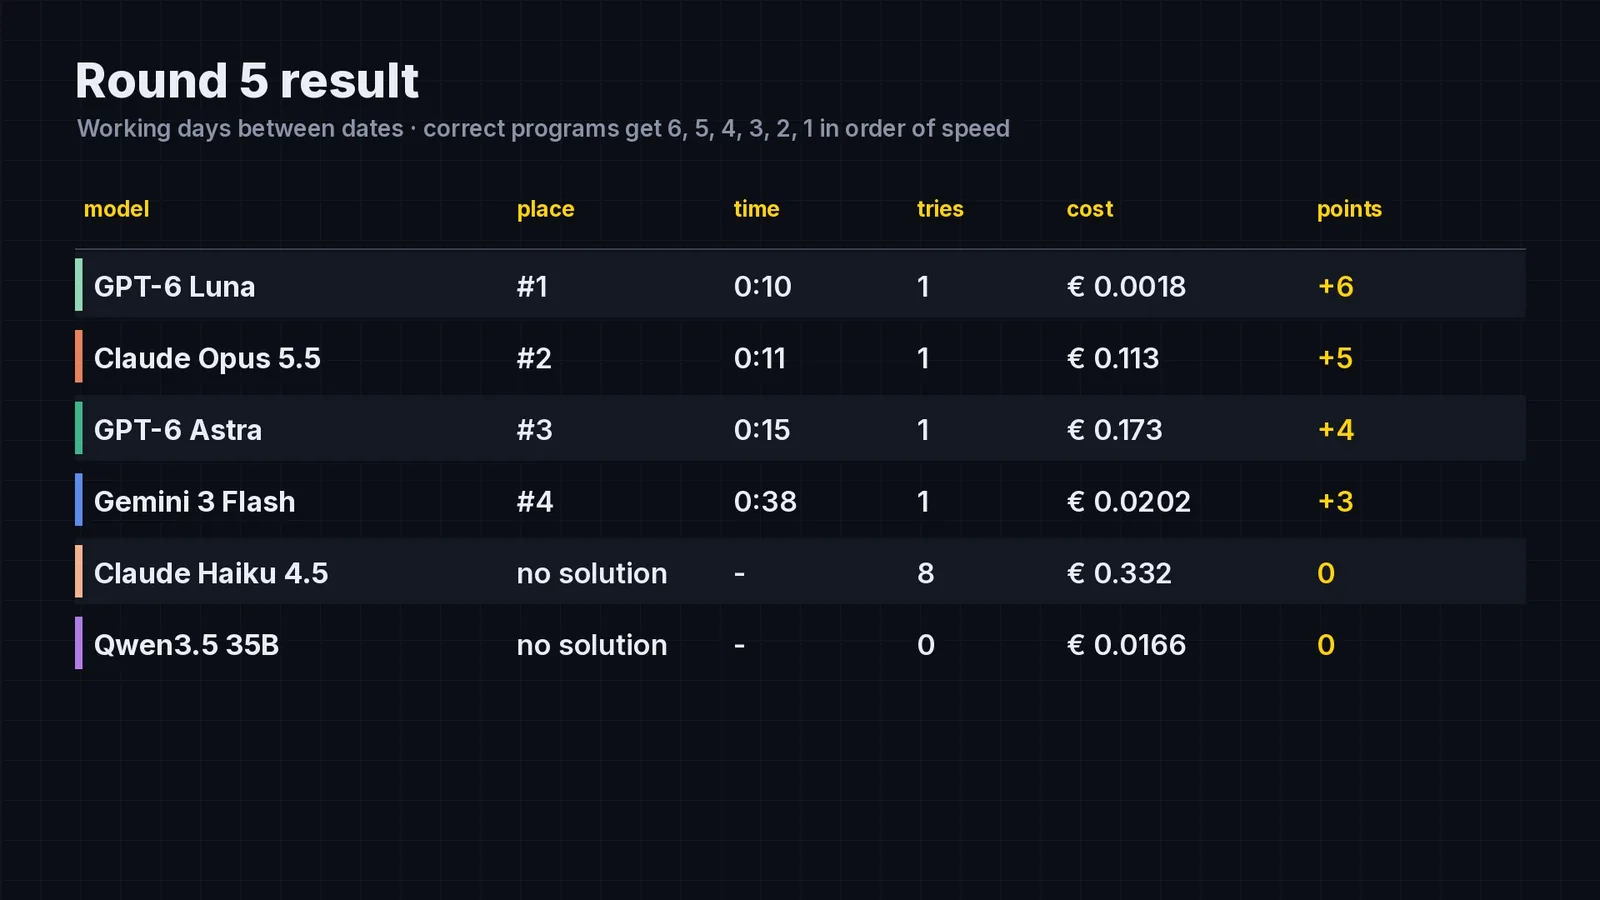
GPT-6 Luna won, met alle tien opdrachten in één keer correct. Claude Opus werd tweede, ook met tien op tien, steeds net iets later. GPT-6 Astra werd derde, Gemini vierde: ook die twee losten alles op, alleen trager. Claude Haiku miste drie opdrachten, telkens op een randgeval. Qwen loste zeven opdrachten correct op, maar haalde drie keer de tijdslimiet niet.
En dan de rekening
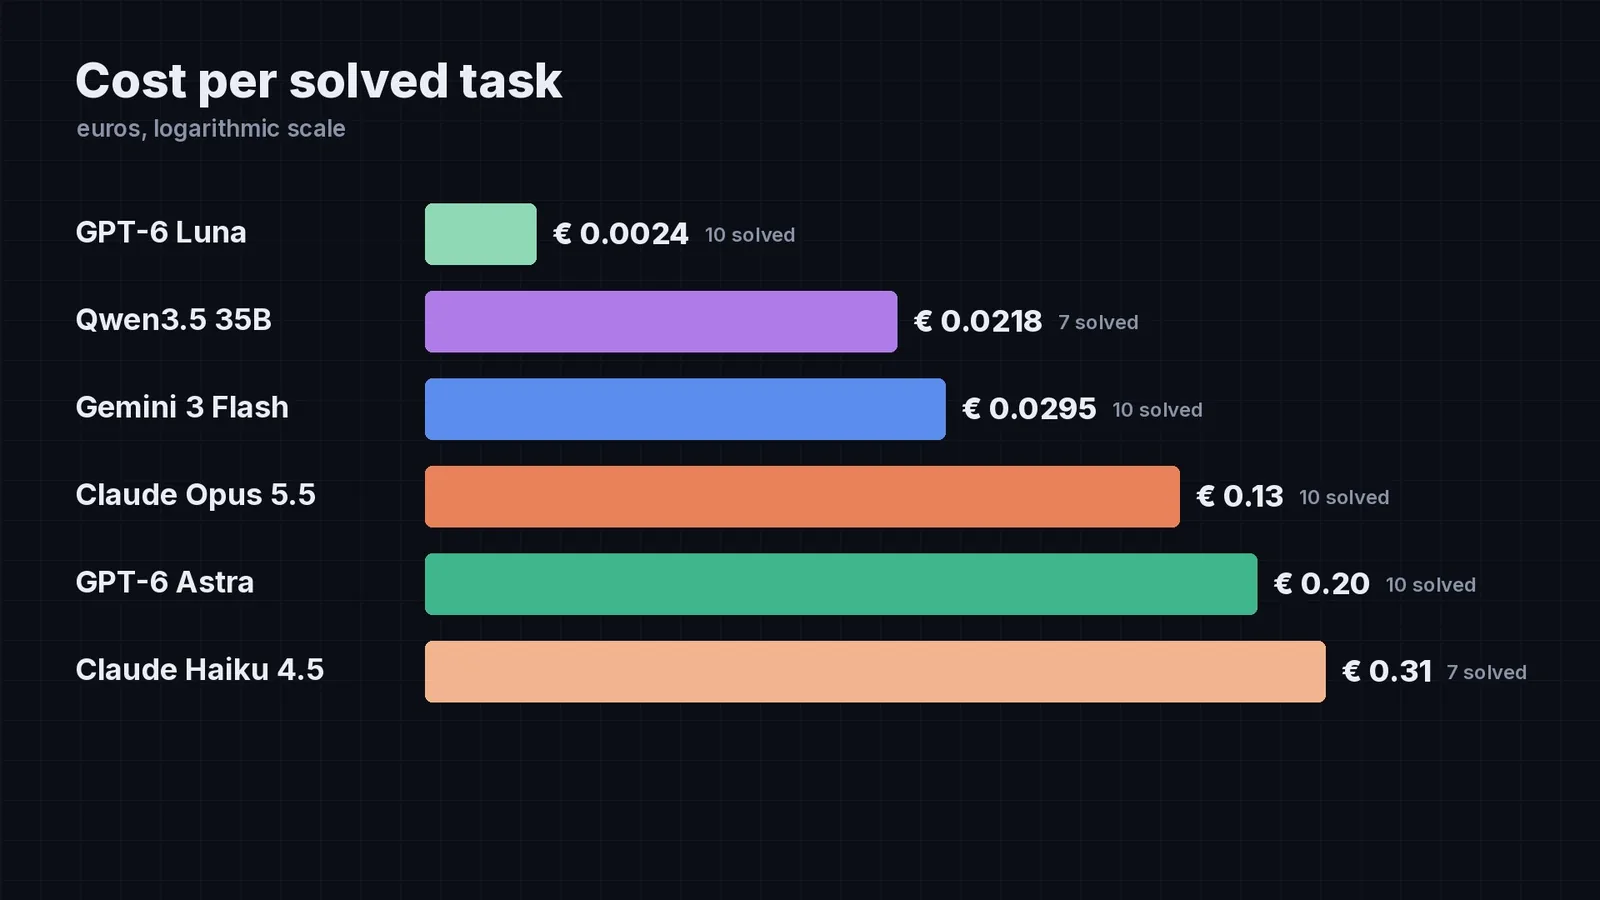
Hier wordt het interessant. Het snelste model was ook het goedkoopste: GPT-6 Luna loste het hele toernooi op voor een paar cent. De luxe modellen kostten per oplossing tientallen keren zoveel, voor exact hetzelfde resultaat. Het duurste per oplossing was Claude Haiku, het "goedkope" model: zijn afgekeurde pogingen kostten ook geld.
Alle modellen samen kostten dit toernooi ongeveer zes euro. De AI-scheidsrechter die de programma's nalas, kostte alleen al meer dan het hele toernooi van de winnaar.
Wat als je op kosten rekent?
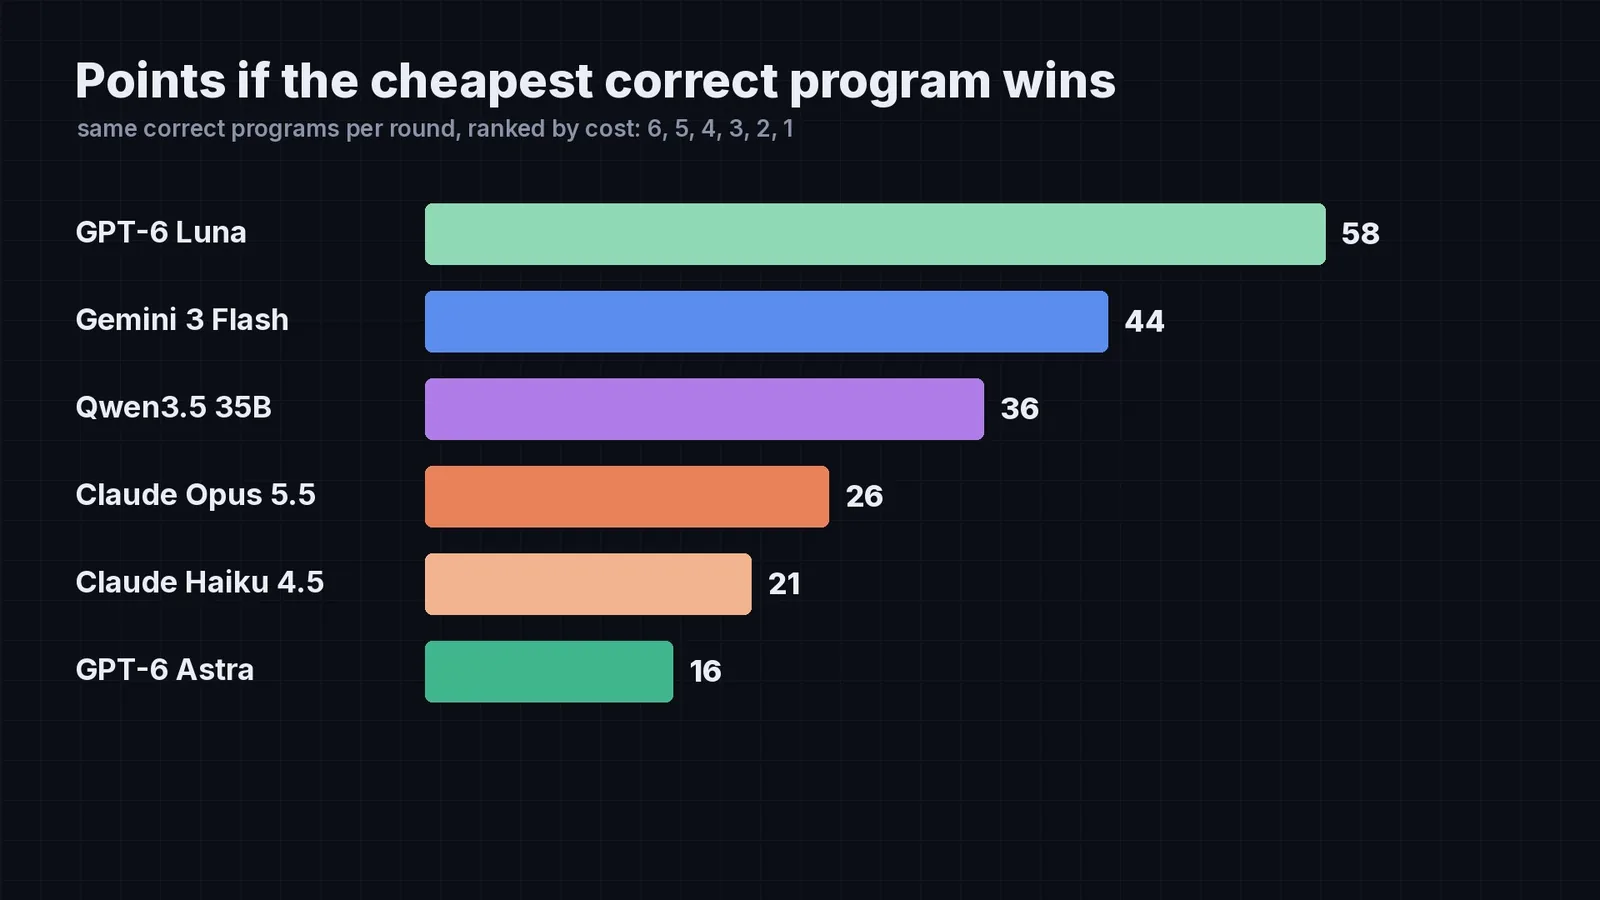
De punten gingen naar snelheid. Maar niet elk proces heeft haast. Een rapport dat 's nachts draait, mag een minuut duren als het een tiende kost. Dus rekende ik hetzelfde toernooi opnieuw door: dezelfde correcte programma's, maar nu krijgt de goedkoopste zes punten.
Dan kantelt de stand. Luna blijft eerste, maar Gemini wordt tweede en onze eigen Qwen schiet naar de derde plaats. Opus zakt naar het midden, en Astra, snel en altijd correct, wordt laatste.
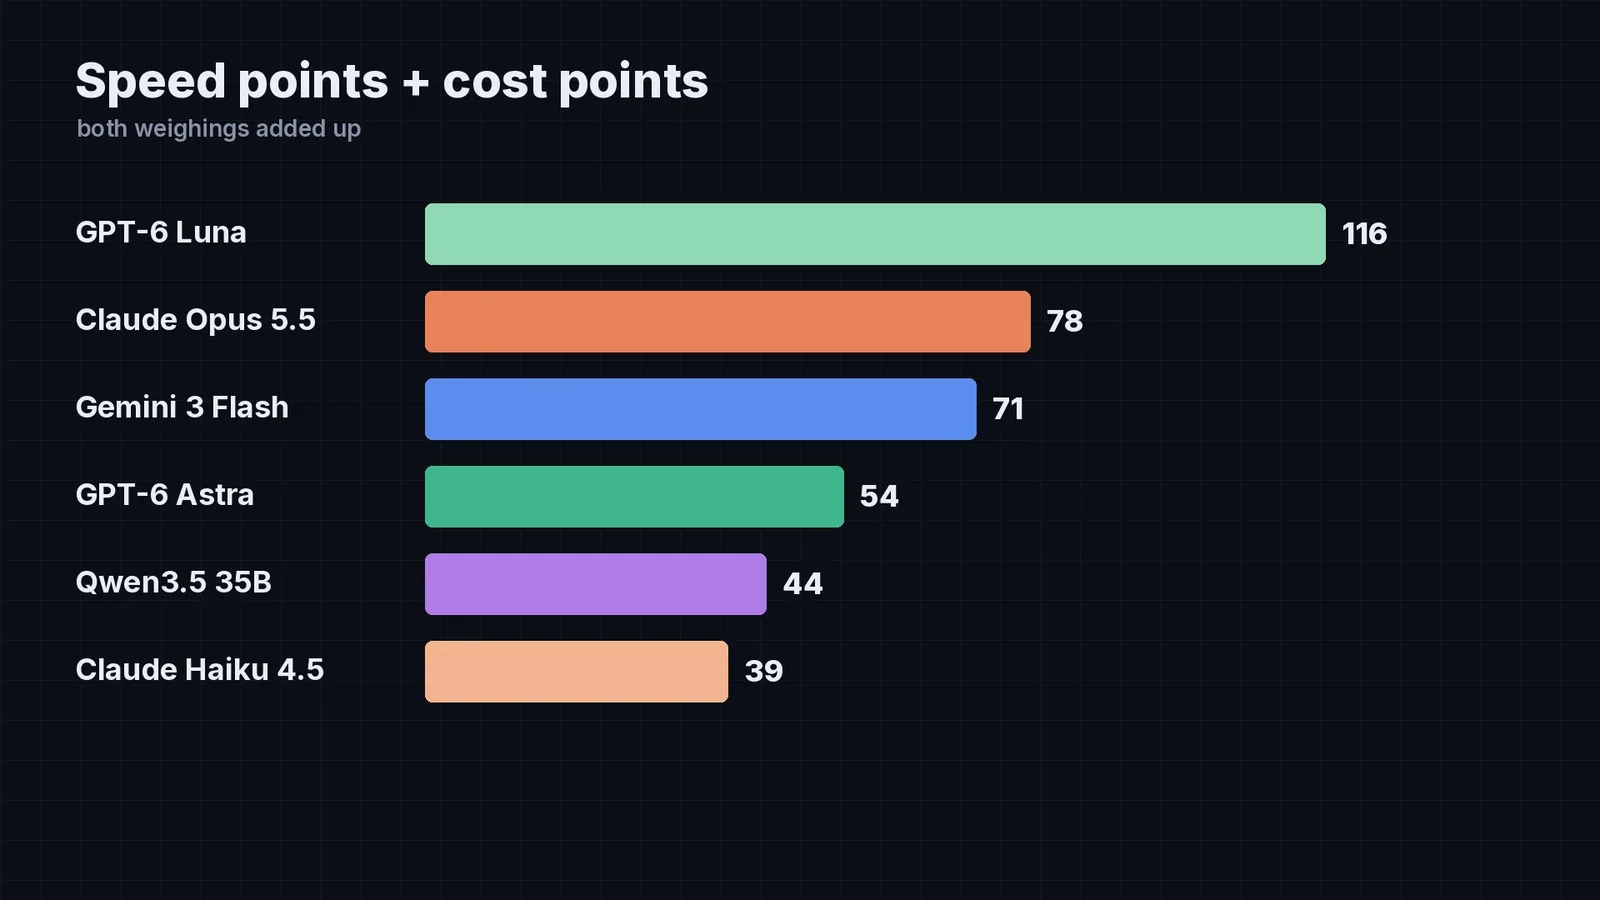
Tel je beide op, dan staat Luna ruim bovenaan, gevolgd door Opus en Gemini. Het "beste model" bestaat dus niet. Er is alleen het beste model voor wat een proces op dat moment nodig heeft.
Wat we ermee doen
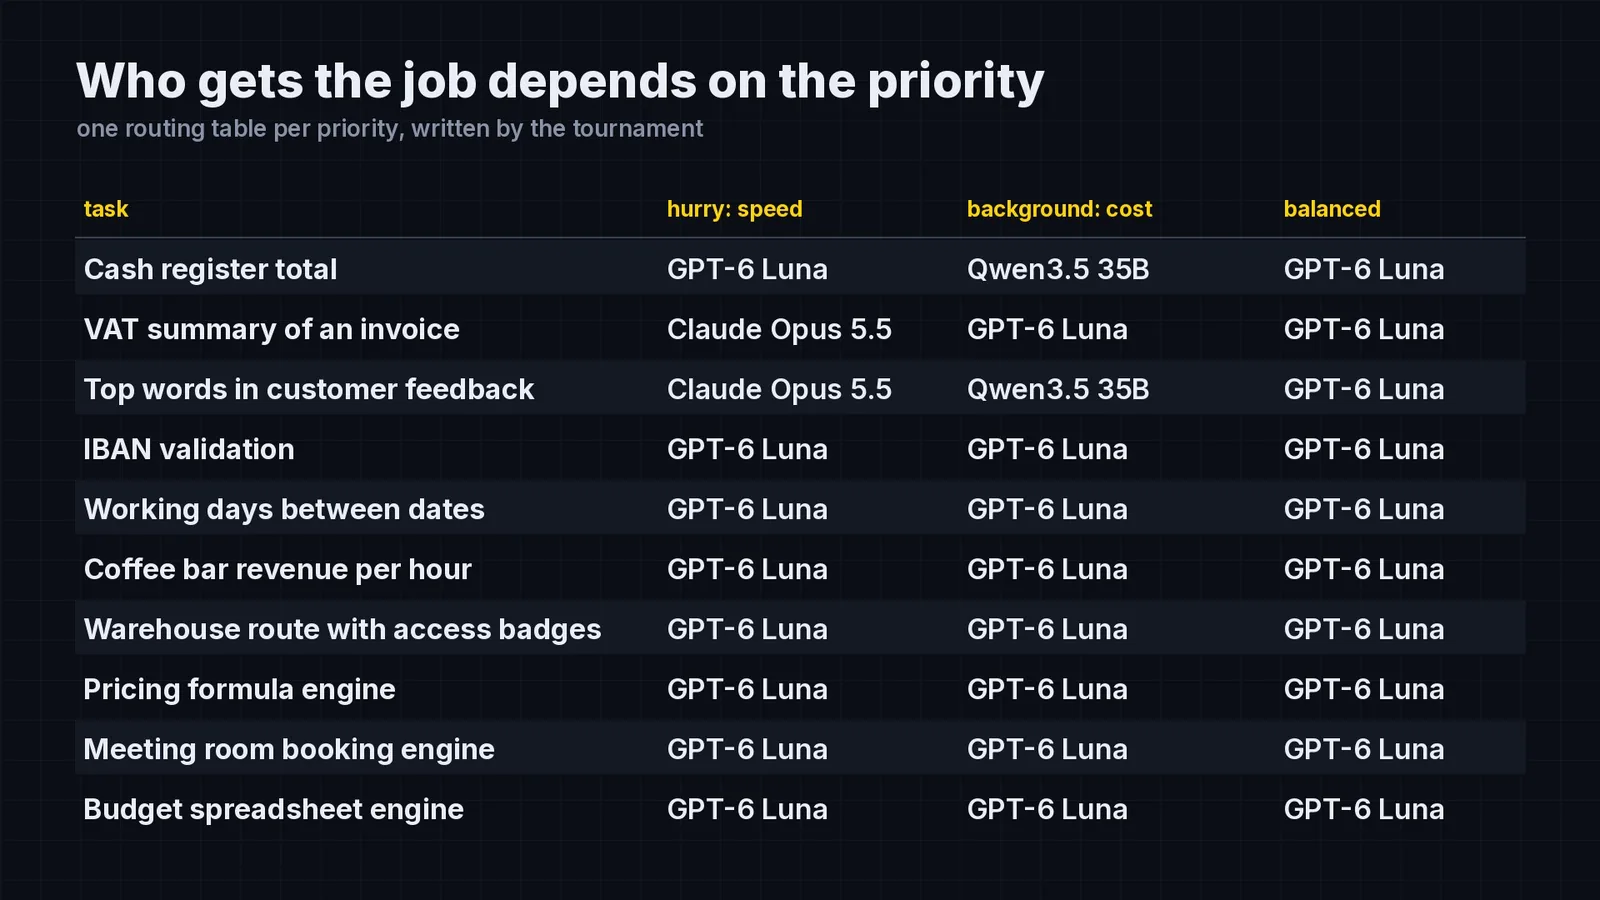
In de Virtual Company Builder geeft elk proces aan wat telt. Wacht er een klant? Dan telt snelheid. Draait er een nachtelijk rapport? Dan tellen de kosten. Al het andere krijgt de beste balans. Het toernooi schrijft dus niet één routeringstabel, maar één per prioriteit. Hetzelfde soort taak kan naar een ander model gaan, afhankelijk van het moment.
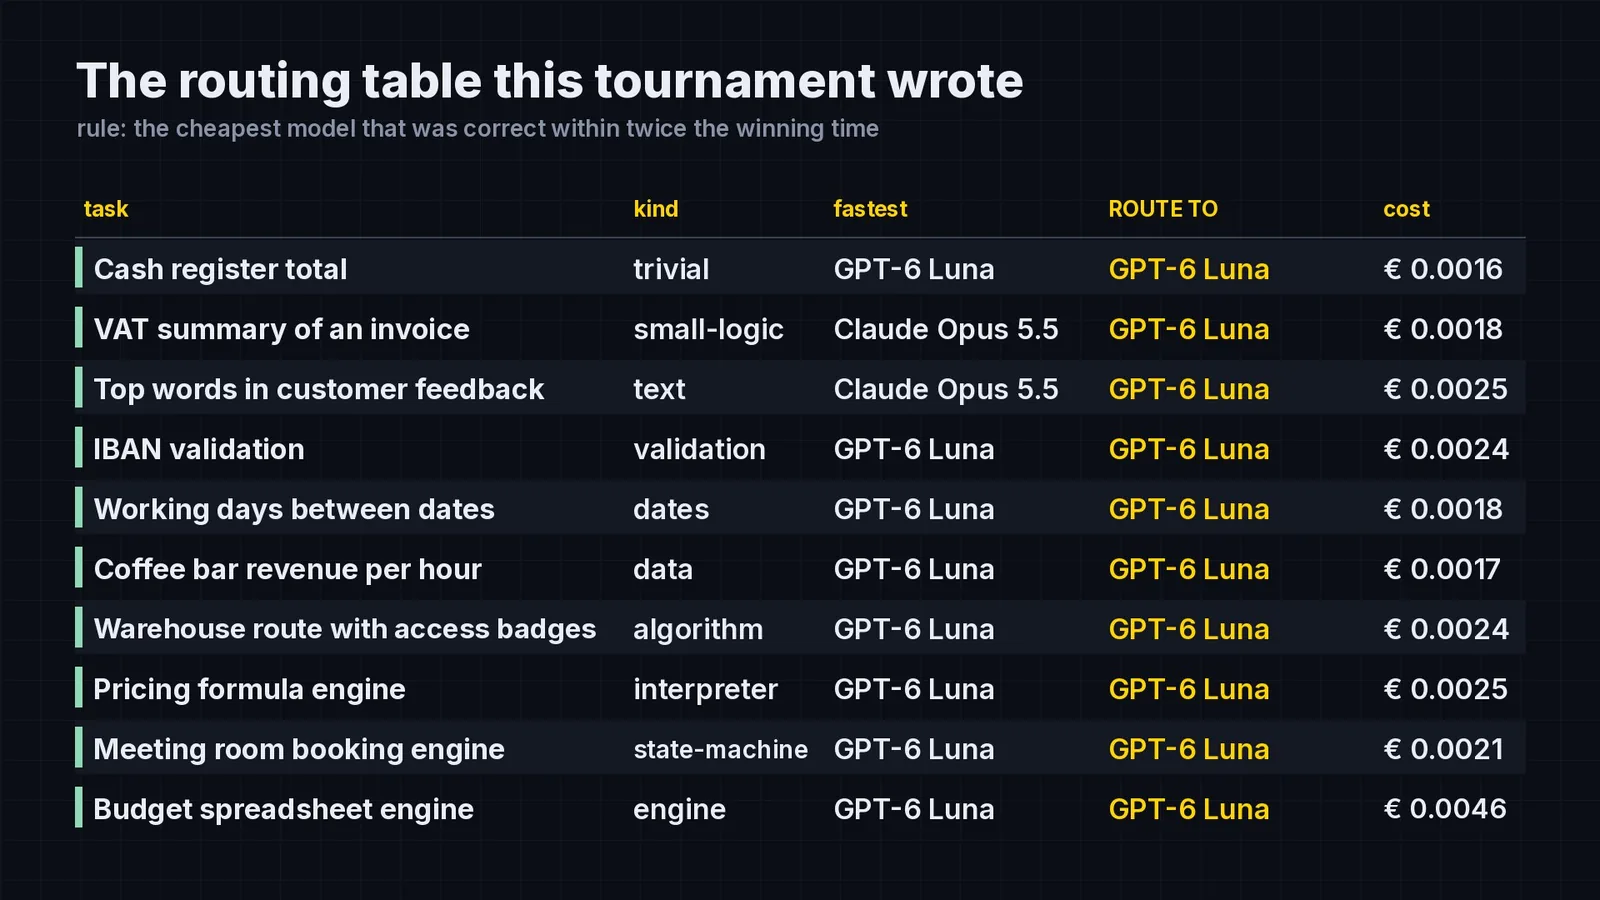
Voor de gebalanceerde tabel gebruikte ik een eenvoudige regel: het goedkoopste model dat correct was, binnen twee keer de winnende tijd. Deze keer gaf dat bijna overal hetzelfde antwoord, omdat één budgetmodel bijna overal won. Dat is een uitslag van deze nacht, geen wet. Volgende maand, met een nieuw model of een nieuwe prijs, kan de tabel er heel anders uitzien.
Hoe je snelheid en kosten precies tegen elkaar afweegt, is een keuze die ik nog verder uitwerk. De data om die keuze te maken, ligt er nu.
De agents organiseren hun eigen toernooien
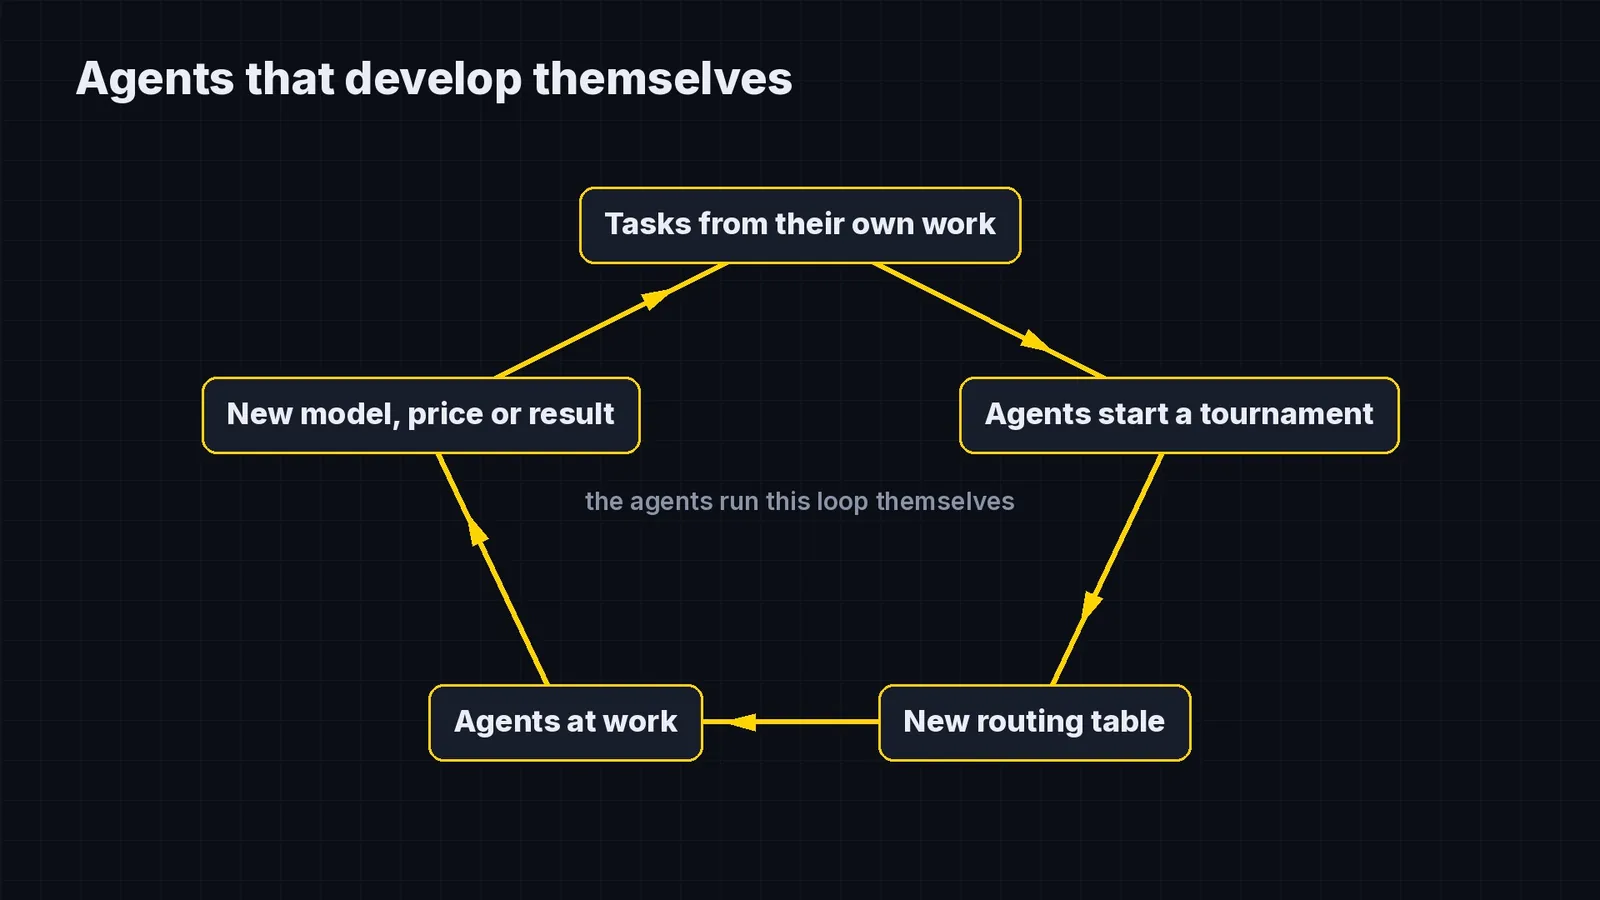
Het mooiste deel: niemand hoeft deze toernooien te starten. In de Virtual Company Builder organiseren de agents ze zelf. Ziet een agent een nieuw model verschijnen, een prijs veranderen of zijn eigen resultaten teruglopen, dan haalt hij opdrachten uit zijn eigen recente werk, zet hij een arena op zoals die van deze nacht, laat hij de modellen strijden, leest hij de nieuwe routeringstabel en schakelt hij over.
Dat betekent dat we nooit één keer een model kiezen en daar jaren aan vastzitten. Geen keuze op gevoel, geen keuze op een ranglijst uit een lab, geen afhankelijkheid van één leverancier. De organisatie meet zelf, op haar eigen werk, onder haar eigen omstandigheden, en past zich aan. Na de lancering blijft ze zo beter en goedkoper worden, zonder dat er een mens aan hoeft te zitten.
Beperkingen, eerlijk benoemd
- Eén nacht, één ronde per opdracht. Snelheid schommelt per poging. Een tweede toernooi kan een andere winnaar per ronde geven. Daarom moet dit herhaald worden, en dat is precies het idee.
- Qwen was benadeeld. Tijdens het toernooi draaide op dezelfde server ook de montage van de video. Qwen draait op de processor, en zakte daardoor van vijf à zeven naar twee à drie tokens per seconde, soms nog minder. Zijn tijden zijn dus te pessimistisch, en in drie rondes liep hij tegen de limiet aan. Dat had niet mogen gebeuren. In de werkinstructie staat nu de regel dat er tijdens een toernooi niets zwaars meedraait.
- Python. Alle opdrachten werden in Python opgelost. In een andere taal kan de uitslag anders zijn.
- Bekende soorten werk. Opdrachten als een IBAN-controle lijken op wat modellen tijdens hun training hebben gezien. Juist daarom is de volgende stap om opdrachten uit onze eigen processen te halen.
- Kosten zijn benaderingen, op basis van gepubliceerde prijzen en een vaste wisselkoers. De verhoudingen zijn betrouwbaarder dan de exacte bedragen.
- Gereedschap telt mee. Elk model werkte met zijn eigen CLI. Wat je meet, is dus het model plus zijn gereedschap: precies zoals je het in de praktijk zou inzetten.
Hoe het gebouwd is
Het hele toernooi is een herbruikbare opzet. Een opdrachtenset is één bestand: per opdracht de tekst, voorbeelden, een referentieoplossing en een generator voor verborgen toetsen. Een nieuw toernooi is een nieuwe set plus één commando. Alles wordt bewaard: elke regel uitvoer van elk model, elke ingediende versie, elke uitslag, de opnames van het dashboard. Een nieuwe weging, een nieuw klassement of een nieuwe video kan dus zonder de rondes opnieuw te spelen.
Tot slot
Dit toernooi zegt niet welk model het beste is. Het zegt welk model deze nacht het beste werk deed, op deze taken, onder deze omstandigheden. En dat is precies de vraag die een autonome organisatie zichzelf steeds opnieuw moet stellen.
De video van de hele wedstrijd laat alle zes de modellen naast elkaar zien, live, met de code, de afgekeurde pogingen, de kosten per ronde en de eindstand op snelheid en op kosten: https://youtu.be/P76ZpwlJHtY
Floris Knol is software engineer. Hij bouwt AI-agents die bedrijfsprocessen automatiseren en traint teams om ermee te werken.
Zie ook
De factuur met een nieuw rekeningnummer: wat een agent mag doen en wat niet
Stel je een crediteurenafdeling voor van een groothandel. Negen mensen, ongeveer zesduizend facturen per maand. Het merendeel komt per mail als pdf, de rest via een gestructureerde koppeling. Bij elke factuur moet…
Tweehonderdvijftig euro en niets meer: het startkapitaal van een agent
Mijn agents mogen sinds kort echt iets uitgeven. Daar hoort een simpele regel bij: elke agent met een goed idee krijgt 250 euro startkapitaal, in totaal, en niets meer.
Een agent bestelt een server. Dit is wat ik hem liet doen, en wat niet
Beetje bij beetje geef ik mijn agents meer ruimte. De eerste echte stap was een server. Dex, mijn Operations-agent, bestelde er een, installeerde er zelf NonStopWorker op en liet zien dat het draaide. Van bestelling tot…